1.2.3390 - полное восстановление работы SE::Google, новый docker образ aparser/runtime:headful

УлучшенияИсправления в связи с изменениями в выдаче
- Полностью восстановлена работа парсера
SE::Google под Linux и Windows
- В
- В
SE::Bing::Translator актуализирован список языков
- В
Net::Whois добавлена поддержка домена .us.com
- В
Util::Turnstile добавлена поддержка сервиса разгадывания BotLab
- Добавлен docker образ aparser/runtime:headful - помогает увеличить скорость парсинга в
Исправления
- В
- В
Reddit:: PostInfo исправлен сбор комментариев к публикациям
- В
SE::Yandex:: Direct исправлен сбор $domain, $title, $text
- В
SE::Yandex::WordStat исправлен сбор частотности, а так же разгадывание смарт-каптчи
- В
- В
- В
FreeAI:: Perplexity исправлена работа функции New attempt when match для языков, отличных от английского


A-Parser - продвинутый парсер поисковых систем, Suggest, WordStat, PR, DMOZ, Whois, DNS, etc
(Ответов: 348, Просмотров: 57492)
- 29.05.2026 13:47Опытный


- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23
- 0
- 18.06.2026 12:31Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23
Дайджест A-Parser: обновление дополнительных парсеров

Дайджест A-Parser: обновление дополнительных парсеров
Внешние сервисы регулярно изменяют структуру страниц, форматы выдачи, механизмы авторизации и способы загрузки данных. Мы отслеживаем такие изменения и вносим необходимые доработки, чтобы вы могли продолжать использовать парсеры в своих рабочих процессах.
Парсер SimilarWeb
Обновление парсера для сбора данных SimilarWeb- Восстановлена корректная работа парсера
- Модуль обхода защиты переработан с Puppeteer на Playwright
- Улучшена совместимость с текущими механизмами защиты SimilarWeb
Обновление парсера для проверки email-адресов- Исправлена проверка почты в Outlook/Hotmail, Mail.ru, Яндексе, Рамблере
- Добавлена поддержка Yahoo через Puppeteer
- Добавлена поддержка AOL через Puppeteer
- Добавлен домен hotamil.com
Обновление парсера для сбора данных об удаленных доменах- Пресет полностью переписан на JS-парсер
- Учтена новая обязательная авторизация с MFA
- Реализована загрузка данных таблицы через XHR-запросы
- Обновлен набор колонок: убрана ALEXA, добавлены WBY, MMGR и List
Обновление парсера для сбора постов из X- Исправлена совместимость с новой структурой X API
- Исправлена обработка аккаунтов с promoted content
- Исправлена работа с курсорами пагинации
- Улучшен экспорт Post ID в Excel для корректного отображения длинных идентификаторов
Обновление парсера для сбора видео с YouTube-каналов- Добавлена совместимость с новым форматом YouTube lockupViewModel
- Исправлена обработка ytcfg для каналов с нестандартной структурой
- Исправлено получение длительности видео
- Добавлен сбор описаний видео
- Переработана архитектура для параллельной обработки роликов
Если вы хотите, чтобы мы более подробно раскрыли какой-то функционал парсера, у вас есть идеи для новых статей или вы желаете поделиться собственным опытом использования A-Parser — отписывайтесь здесь.
Подписывайтесь на наш канал на Youtube - там регулярно выкладываются видео с примерами использования A-Parser, а также следите за новостями в X.


- 0
- 28.07.2026 16:57Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23

NextGen UI — новый интерфейс A-Parser
В новом обновлении мы завершили переход на NextGen UI — теперь он используется по умолчанию в версиях A-Parser для Windows и Linux.
Интерфейс полностью переписан с нуля на новой архитектуре, работает в браузере и в формате Desktop-приложения, поддерживает тёмную тему и сохраняет привычные возможности A-Parser.
С момента первой тестовой версии NextGen UI получил множество крупных улучшений: расширенную работу с логами, встроенные инструменты тестирования и отладки, улучшенное управление заданиями и пресетами, планировщик, групповые операции и автоматическое восстановление после сбоев.
Основные возможности NextGen UI- Расширенная работа с логами. Доступны поиск, фильтрация, выделение, копирование и скачивание записей. Логи отображаются непосредственно при тестировании задания в редакторе, а отладочный вывод можно быстро включать и отключать.
- Наглядная отладка. JS-дампы, HTTP-запросы и ответы отображаются в виде раскрываемых JSON-деревьев, изображения выводятся прямо в логах. Для регулярных выражений добавлен быстрый переход во встроенный Тестер регулярок.
- Улучшенный Parser Test. Настроенный в тестере парсер можно перенести непосредственно в редактор задания. При замене парсера предлагается сохранить совместимые переопределённые настройки.
- Информативная очередь заданий. В очереди отображаются используемый пресет, настройки парсера, точное время запуска и расчётное время до завершения. Добавлены массовое выделение заданий и групповые действия.
- Удобное управление пресетами. Пресеты можно переименовывать, искать и сортировать. При импорте пресет сначала открывается в редакторе, где его можно проверить и изменить перед сохранением. Для действий «по завершении» добавлены отдельные поля выбора пресетов заданий и конфигураций потоков.
- Встроенные инструменты. В NextGen UI доступны планировщик заданий, Тестер регулярных выражений, редактор tools.js, расширенные настройки и диалог API-запроса с редактором кода.
- Сохранение рабочего состояния. Интерфейс запоминает открытые разделы, выбранные вкладки, страницы очереди, прокрутку, положение и размер окон, а также состояние редактора JS-парсеров.
- Обновлённая тёмная тема. Переработана цветовая схема, повышена контрастность и улучшены визуальные акценты в редакторе заданий.
- Работа с большими объёмами данных. Ускорена загрузка логов, снижена нагрузка на диск, большие списки файлов подгружаются постепенно по кнопке «Загрузить ещё».
- Автоматическое обслуживание. Хост и порт ядра настраиваются через интерфейс, свободный порт подбирается автоматически. После сбоя ядро перезагружается, а после обновления A-Parser автоматически перезапускается.
Полностью восстановлена работа SE::Google
Вторым ключевым изменением обновления стало полное восстановление работы парсера Google.
В последние недели Google последовательно усиливал защиту и менял механизмы формирования выдачи, из-за чего сбор результатов стал заметно сложнее. Работа над адаптацией парсера велась практически непрерывно.
В результате:- полностью восстановлена работа Google в режиме Browser на Windows и Linux для профилей desktop и mobile;
- полностью восстановлена работа HTTP-режима на всех платформах и профилях;
- улучшена работа с пагинацией;
- добавлено определение неполной выдачи — одной из разновидностей защиты Google;
- добавлено определение новой капчи «Verifying your request»;
- исправлено смешивание браузерных заданий при работе через Redis API;
- восстановлена работа Google Images;
- исправлена работа Google Translate в режиме desktop;
- восстановлен сбор отзывов в Google Reviews;
- исправлен вывод общего количества отзывов $totalcount;
- исправлен сбор переменной $claim в Google;
- добавлен сбор общего рейтинга организации $avgrating.
Новый парсер SE::Rutube
Добавлен новый парсер Rutube для сбора результатов поиска видео на Rutube.
Улучшения- Whois - добавлена работа через серверы RDAP и переменная $rdapserver. Добавлена поддержка доменных зон `.gr` и `.ελ`.
- Wildberries ProductInfo - добавлен сбор цены с кошельком WB в переменную $walletPrice.
- Turnstile - добавлена возможность обработки Cloudflare Turnstile через XEvil.
- GroupSc****r - добавлены новые переменные и массивы, фильтр по дате и возможность пропускать пересланные сообщения.
- TikTok Profile - парсер переведён на Puppeteer для обхода блокировки HTTP-запросов со стороны Akamai; восстановлен сбор ссылок на подписки.
- Kimi - восстановлена работа и добавлена авторизация через Bearer token.
- Brave - добавлена обработка капчи.
Исправления в связи с изменениями на источниках- Bing - исправлен парсинг в режимах Browser и HTTP.
- You - восстановлена работа парсера.
- Startpage - восстановлена работа основной выдачи.
- Startpage Videos и Startpage Images - восстановлена работа парсеров.
- DuckDuckGo и DuckDuckGo Images - восстановлена работа парсеров.
- Instagram Search - восстановлена работа, исправлена ошибка 403 Forbidden.
- Instagram Tag - устранены дубли публикаций в результатах.
- Instagram Profile - восстановлена работа и исправлена смена прокси при сборе подписчиков.
- Wildberries ProductsList - восстановлена работа и исправлен нестабильный сбор данных.
- Wildberries ProductInfo - восстановлена работа и исправлены ошибки на отдельных запросах.
- Amazon - исправлен сбор части результатов.
- Domain - восстановлен обход Cloudflare.
- Turnstile - исправлена работа в режимах Browser и Auto.
- Whois - исправлена работа с зонами `.direct`, `.insure`, `.global`, `.services`, `.travel` и `.co`.
- ChatGPT - исправлен парсинг списков.
- Perplexity, DeepAI и Translator - восстановлена работа.
- Radar, LastPrice и Mustat - восстановлена работа.
Последний раз редактировалось Forbidden; 28.07.2026 в 17:04.
- 0
- 04.08.2026 21:35Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23

Какие сайты получают видимость в ChatGPT и Perplexity — и можно ли судить об этом по одному ручному запросу?
Мы закончили большое исследование источников в ответах ChatGPT и Perplexity. Нас интересовали не отдельные удачные скриншоты, а системная картина: какие домены появляются в ответах ИИ, насколько различаются две системы и что происходит со списком источников при смене страны и прокси.
Для эксперимента собрали и проанализировали 17 873 источника по 12 слот-играм, 6 коммерческим интентам и 4 странам. Запросы запускались через резидентские прокси целевых стран и смешанный прокси-пул, а ссылки нормализовались и дедуплицировались по паре query + URL.
Уже на первом сравнении стало понятно, почему единичной ручной проверки недостаточно. После нормализации у ChatGPT было 1 223 домена, у Perplexity — 2 019, а общими оказались только 450 доменов. Коэффициент сходства между системами составил всего 16,12%. ChatGPT чаще выводил официальных провайдеров и Reddit, а Perplexity — классические аффилейт-обзорники.
Но количество цитирований оказалось только половиной картины.
- В ChatGPT сайт Pragmatic Play лидировал по общей частоте — 303 цитирования. При этом только 23,1% его ссылок вошли в Top-3.
- У Reddit было меньше цитирований — 182, зато 68,7% ссылок оказались в первой тройке сохранённого списка источников.
- Получается, лидер по числу ссылок и лидер по заметности — не обязательно один и тот же домен.
Отдельно проверили влияние IP. В контрольном тесте из запросов убрали название страны и отправляли одинаковые англоязычные вопросы через резидентские прокси Новой Зеландии, Бразилии, Мексики и Казахстана.
Даже без географических подсказок в тексте пересечение доменов у ChatGPT составило только 16,28%. То есть один запрос с одного IP показывает лишь конкретный срез, а не устойчивую картину видимости.
Именно здесь разовая выгрузка превращается в задачу для регулярного мониторинга: кто удерживается в источниках, кто появляется впервые, кто выпадает и как меняется доля Top-3 по странам и режимам прокси.
A-Parser позволяет поставить такой сбор по расписанию и получать данные в одинаковом формате без ручного копирования ответов.
В полной теме:
- методика эксперимента и формула запросов;
- сравнение ChatGPT и Perplexity;
- страновые срезы и влияние разных режимов прокси;
- анализ числа цитирований, средней позиции в массиве источников и доли Top-3;
- открытый датасет основного сбора и контрольного теста;
- готовые пресеты для ChatGPT и Perplexity, чтобы повторить сбор на своей нише.
Открыть исследование, посмотреть результаты и скачать материалы
Если уже проверяли видимость своих сайтов или конкурентов в ответах ИИ, интересно сравнить опыт: насколько сильно у вас меняется набор источников между ChatGPT, Perplexity и разными GEO?- 0
- 11.08.2026 01:50Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23
В каких нишах небольшие каналы выигрывают в выдаче YouTube — и почему высокий ранг не гарантирует просмотры?
Представьте парадокс: видео автора с 700 подписчиками забирает 2,7 миллиона просмотров и 3-е место в поисковой выдаче YouTube по iPhone, а в финансовых темах — крипте и дропшиппинге — ни одно из 59 видео небольших каналов не преодолевает планку в 20 000 просмотров. При этом в обзорах криптобирж авторы небольших каналов занимают каждый третий ролик в ТОП-10: 45 из 136, или 33,09%.
Чтобы выяснить, где алгоритмы дают реальный охват, а где ранжирование оказывается «холостым», мы провели исследование выдачи с помощью A-Parser. Для эксперимента собрали 34 070 строк поисковой выдачи YouTube по 28 темам и 343 подсказкам, сведя датасет к 21 537 уникальным видео.
Главное открытие: высокий ранг в поиске и реальные просмотры — это две разные задачи.
- Визуальные ниши дают шанс малым авторам: В распаковках гаджетов, фитнесе, DIY и коротких роликах с демонстрацией AI-инструментов доля прорывных видео от небольших каналов (от 100 до 10 000 подписчиков, набравших от 20 000 просмотров и превысивших число подписчиков в 10+ раз) достигала 23,15% от уникальных видео в ТОП-10.
- Коммерческие ниши дают позиции, но не дают просмотров: В темах криптобирж, ботов и дропшиппинга малые каналы формировали 33–35% результатов в ТОП-10, но ни один из 59 роликов не достиг 20 000 просмотров. Позиция в поиске есть, а просмотров нет.
- Один ролик закрывает сразу кластер подсказок: 22,38% видео появлялись минимум по двум поисковым подсказкам, а отдельные ролики-лидеры ранжировались сразу по 21 подсказке.
A-Parser позволяет превратить этот процесс из ручного просмотра сотен запросов в регулярный автоматизированный мониторинг ниши с помощью 3-шаговой цепочки: SE::YouTube::Suggest ➔ SE::YouTube ➔ SE::YouTube::Video.
В полной теме:
- подробная методика эксперимента и структура датасета на 34 070 строк;
- 4 фильтра для поиска прорывных видео небольших авторов;
- разбор 3 групп тем (визуальные, коммерческие, с ограничениями фильтрации);
- анализ тегов и модификаторов заголовков для составления ТЗ на контент;
- открытый CSV-датасет и готовый пресет A-Parser для повторения исследования.
Открыть исследование, посмотреть результаты и скачать материалы
Если вы уже анализировали выдачу YouTube в своих нишах — поделитесь опытом: в каких тематиках вам чаще попадаются выстрелившие микро-каналы, а где первые места намертво закрепились за гигантами?- 0
- 27.08.2026 09:30Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23
Как выгрузить архив сайта из Wayback Machine: CDX API, чистый HTML и Markdown
Старые статьи, цены и описания исчезают из живого веба вместе с редизайнами и удалёнными разделами. По данным Pew Research Center, 38% страниц из выборки 2013 года были недоступны к октябрю 2023 года. Снимки Wayback Machine помогают вернуть этот исторический слой, но обычный обход архива медленный и приносит в данные панели Wayback и служебные скрипты.
В A-Parser для этой задачи есть два практических сценария:
- No-Code-конвейер: Net::HTTP -> HTML::ArticleExtractor получает URL через CDX API, скачивает чистые снимки и сохраняет результат в JSONL.
- Готовый TypeScript-парсер JS::WaybackCDX: находит снимки, нормализует и дедуплицирует URL, очищает текст через Mozilla Readability и сохраняет отдельные Markdown-файлы с YAML Frontmatter.
- Режим id_: в ссылке на снимок убирает тулбар и внедрённые скрипты Wayback, чтобы в выгрузку попал исходный HTML страницы.
Открыть руководство, скачать готовый парсер и пресеты- 0
- 01.09.2026 23:34Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23
A-Parser 1.2.3593: обход защиты Google /goto, восстановлен SE::Yandex в HTTP и переписан Google Trends
Вышло свежее обновление A-Parser 1.2.3593. Коротко о ключевых изменениях:
- Обход новой защиты Google: поддержан обход редиректов /goto (когда Google скрывает реальные ссылки из выдачи) и обновлен обход защиты.
- SE::Yandex: восстановлена стабильная работа в режиме HTTP.
- SE::Google::Trends с нуля: парсер полностью переписан, возвращен стабильный сбор и добавлена опция Parse to level для глубокого парсинга связанных трендов.
- Стабильность FreeAI::ChatGPT: устранены утечки памяти при длительном сборе, ошибки селекторов и обрезание текста ответов.
- Яндекс Карты и Whois: исправлены просадки скорости в Maps::Yandex и добавлено 12 новых доменных зон в Net::Whois.
- А также другие улучшения и исправления.
Подробный список изменений, инструкции по настройке и обсуждение релиза:
Читать подробнее на форуме A-Parser- 0
- 06.09.2026 01:17Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23
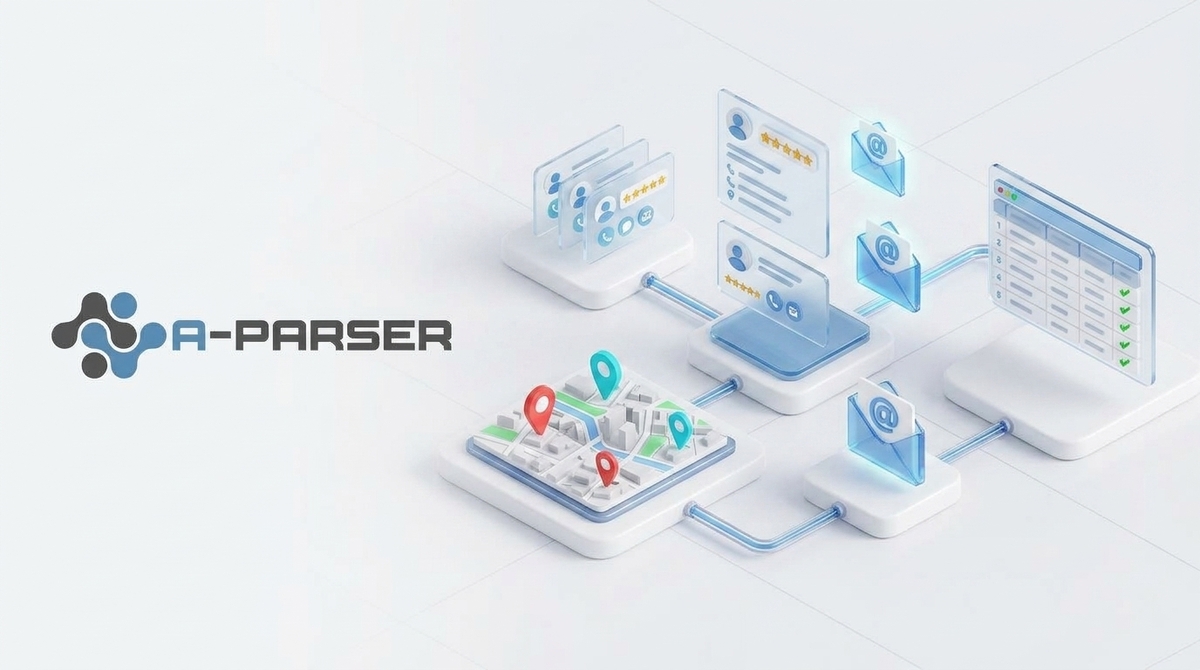
Как собрать B2B-базу компаний с e-mail из Google Maps на полном автопилоте?
Ручной сбор контактов для B2B-продаж и холодных рассылок отнимает кучу времени: найти организацию на картах, скопировать телефон и адрес, перейти на сайт и вручную искать раздел с контактами. На сотнях и тысячах организаций это превращается в бесконечную рутину.
В A-Parser эту цепочку можно автоматизировать в один сквозной запуск: связка Maps::Google и HTML::EmailExtractor выгружает карточки организаций (название, телефон, адрес, рейтинг, отзывы, сайт) и сразу находит опубликованные публичные e-mail на их сайтах. Вместо «голого» списка почт получается готовая таблица с полным контекстом для персонализации.
В статье разобрали пошаговую настройку связки, частые ошибки и приложили готовый пресет для импорта в один клик.
Читать статью, посмотреть пример таблицы и скачать готовый пресет
- 0
- 07.09.2026 20:27Опытный
- Регистрация: 17.08.2010
- Сообщений: 320
- Репутация: 23
Новый личный кабинет A-Parser и бонус до 15%
Мы обновили личный кабинет A-Parser. Теперь всё необходимое для работы собрано в одном месте:
- информация о лицензии;
- управление прокси;
- пополнение баланса;
- история платежей и доступных средств.
В честь обновления действует специальное предложение на пополнение баланса:
- при пополнении от $500 — дополнительно 10%;
- при пополнении от $1,000 — дополнительно 15%.
Максимальный размер бонуса не ограничен.
Как это работает:
- пополняете баланс на $500 — получаете $550;
- пополняете баланс на $1,000 — получаете $1,150.
Бонус можно использовать для оплаты продуктов и сервисов A-Parser. Акция действует при любом доступном способе оплаты.
[B][SIZE=5][url=https://l.a-parser.com/BYclR]- 0


Тэги топика:

Похожие темы
| Темы | Раздел | Ответов | Последний пост |
|---|---|---|---|
LTK Parser - парсер поисковых подсказок на разных языках | Софт, скрипты, лицензии | 12 | 06.05.2012 21:10 |
Парсер контента под дорвеи и сателлиты X-Parser | Софт, скрипты, сервисы | 0 | 15.08.2010 23:51 |
KD Parser - парсер ключевых слов | Софт, скрипты, лицензии | 2 | 10.04.2010 21:47 |
Хороший Парсер Я.Директ и Wordstat - Магадан | Поисковые системы | 10 | 24.11.2009 16:52 |
Хороший Парсер Я.Директ и Wordstat - Магадан | Софт, скрипты, сервисы | 4 | 15.09.2009 19:38 |
---------- blog camera canon forum html index powershot prices webmasters администрация акция бесплатно ближний быть витрина вконтакт вывод группа гугл давать дальнейший добавить запретить запрос зарабатывать заработок зароботок на рефералах инстагор использовать кейс купить куча лайковый лицензия мануал накручивать необходимый общий передаваться покупка пользователь понедельник программа продвижение ребёнок реклама решить сайт сделка создание сообщение способ так-жий товар топоним форум хватать цена яндекс
Тем:
77,616Сообщений:
763,611Пользователей:
30,082Сейчас на сайте:
0 пользователей и 262 гостей

